Часть 1Глава 3
Почему AI уверенно ошибается
- Ядро
- 15 минут чтения
- Практика
- 40 минут
- Уносите
- карточку «Семь уверенных ошибок» и первые строки журнала проверки
Блоки без пометки — ядро; «задание» — практика; «расширение» — можно пропустить.
Вступление
Реальная история · 2023В 2023 году нью-йоркский юрист готовил документ для федерального суда и попросил AI-ассистента ChatGPT подобрать прецеденты. Тот подобрал. Названия дел, номера, цитаты из решений — всё как у людей.
Юрист решил перестраховаться и спросил у чата, реальные ли это дела. Чат заверил: реальные, их можно найти в авторитетных юридических базах.
Шести дел из списка не существовало. Ни одного.
Судья назвал их выдуманными решениями с выдуманными цитатами. Юристы вместе с фирмой заплатили 5 000 долларов штрафа, а история облетела весь мир.
Самое неприятное здесь даже не ошибка — ошибаются все. Неприятно, как он ошибся: гладко, подробно, уверенно. И подтвердил, когда спросили в лоб.
Че вообще происходит?
Вы почти наверняка видели это в мелком масштабе. Попросили цифры для презентации — получили цифры со ссылкой на исследование, которое не гуглится. Попросили статью закона — получили статью, в которой написано не то. Попросили цитату известного человека — получили красивую фразу, которую он никогда не говорил. Но мог бы. Звучит прямо как он.
Общее у этих историй одно: неправильный ответ выглядит точно так же, как правильный. Тот же тон. Та же уверенность. То же аккуратное оформление с подзаголовками.
С людьми мы привыкли к другому. Коллега, который не уверен, обычно себя выдаёт: «кажется», «надо уточнить», пауза. Поэтому гладкий уверенный ответ по привычке кажется ответом человека в теме. С AI эта привычка подводит: гладкость у него есть всегда, а знание — не всегда.
В главе две вещи: почему он так делает и что с этим делать, чтобы не оказаться тем юристом.
На пальцах
Представьте справочную на вокзале. В окошке сидит Гена. Гена прочитал все справочники мира, но на этом вокзале не был ни разу. А правило у справочной одно: посетитель не должен уйти без ответа.
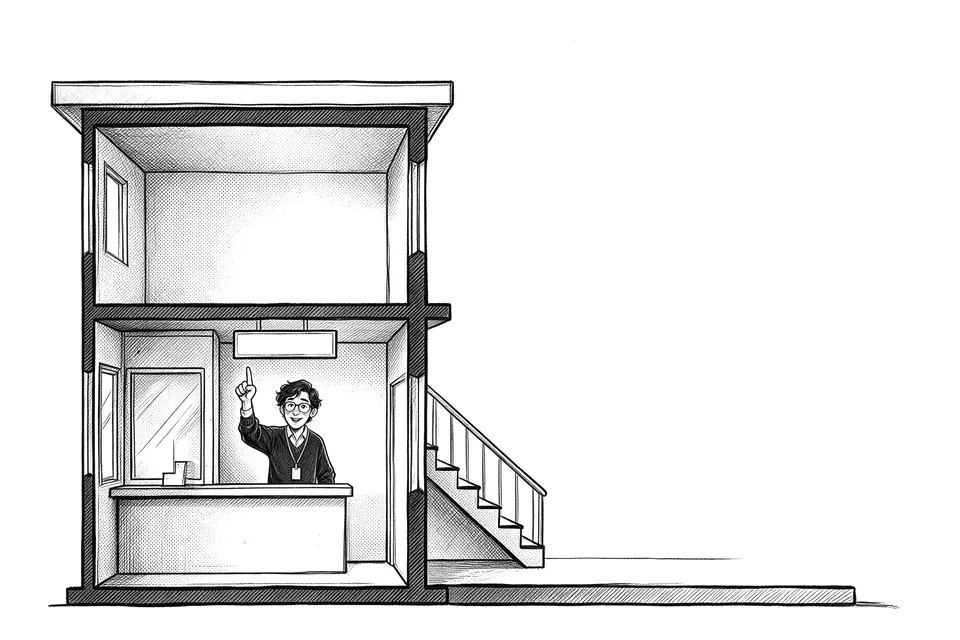
Вы спрашиваете:
Где кабинет 404?
Гена не говорит «не знаю». Гена вспоминает, как обычно устроены вокзалы, и выдаёт самый правдоподобный маршрут:

Третий этаж, налево, сразу за фонтаном! Не пропустите!
Вопрос
Что сделаете?
Гена не врёт. Врать — это знать правду и говорить другое. Гена правды не знает. Он знает, как обычно звучат правильные ответы про вокзалы, и чаще всего это совпадает с реальностью: касса у входа, туалет налево и вниз. Поэтому Гене и верят.
Только в этом здании два этажа. Фонтана нет. Кабинета 404 тоже.
А Гена ответил с той же улыбкой и тем же голосом, что и про кассу. Вот и весь секрет уверенных ошибок: у Гены один голос на всё.
А теперь нормально
Как рождается ответ. пишет ответ по кусочку, каждый раз выбирая правдоподобное продолжение того, что уже написано. Её «знания» — не картотека с фактами, а закономерности, усвоенные на огромном массиве текстов. Частые факты — столица Франции, устройство договора, формулы в Excel — сидят прочно. Редкие — детали нишевого исследования, номер конкретного судебного дела, точная цифра из отраслевого отчёта — размыты.
Когда деталь размыта, модель не останавливается. Она продолжает текст так, как обычно продолжаются такие тексты. Форму она знает на пятёрку: как выглядят ссылка на исследование, номер дела, цитата в кавычках. Содержание — как повезёт. Так рождается идеально оформленная ссылка на статью, которой нет.
Почему он не говорит «не знаю». Проще всего объяснить через экзамен. Модели сравнивают на тестах, и многие тесты засчитывают только верный ответ: за «не знаю» — ноль, ровно как за ошибку. Разработчики хотят высоких баллов, а на таком экзамене угадывать выгоднее, чем признаваться. Помните тесты без штрафа за неверный ответ? Пустая клетка там — худшая стратегия. Современные модели признают незнание чаще. Но рассчитывать на это — всё равно что ждать, что Гена сам скажет: «Я тут впервые». Как это устроено точнее — в «Для задротов».
Ещё две привычки. Он любит соглашаться: ассистентов , а людям приятно, когда с ними согласны. Поэтому «подтверди, что я прав» — худший способ проверить, правы ли вы (подробно — гл. 14). И он может не знать свежего: у модели есть , а о том, что было позже, она узнаёт только из или ваших материалов. Без них уверенно расскажет, как было раньше.
А если в продукте есть поиск и файлы? Выдумок становится меньше, но механизм тот же: кладёт в найденные страницы или ваши документы, модель продолжает текст по ним. Появляются новые ошибки — не тот абзац, слабый источник, чужая цифра. Ссылку модель может и сгенерировать сама. А даже если источник правда был найден и лежал у неё перед глазами, ссылка ещё не доказывает, что модель верно его поняла и что он подтверждает сказанное.
Где аналогия ломается. У Гены есть правило «не отпускать без ответа». У модели такого правила нет — есть склонность, которую сформировали обучение и тесты. А ещё настоящая справочная может позвонить в соседнее окошко — это поиск. Он меняет материал, но не способ отвечать.
Семь уверенных ошибок — главный инструмент главы. Все уверенные ошибки AI укладываются в семь типов.
Выдуманный факт
- Как выглядит
- Событие, характеристика или «общеизвестный факт», которого нет
- Как ловить
- Спросите себя, откуда модель может это знать; найдите первоисточник
Выдуманный источник
- Как выглядит
- Исследование, закон, статья, цитата, ссылка
- Как ловить
- Откройте источник: существует ли он и говорит ли именно это
Устаревший факт
- Как выглядит
- Было правдой когда-то: цены, ставки, законы, должности
- Как ловить
- Спросите «на какую дату?»; всё изменчивое — только с поиском и датой
Искажённая деталь
- Как выглядит
- Факт верный, а цифра, дата, имя или срок — нет. Частая ошибка пересказа документов
- Как ловить
- «Покажи, где это написано» — и сверьте цитату с документом
Ошибка в расчёте или логике
- Как выглядит
- Стройное рассуждение с неверным итогом
- Как ловить
- Попросите показать расчёт или посчитать кодом; проверьте на простом примере
- Как выглядит
- Согласие с вашей ошибкой или слишком тёплая оценка вашей идеи
- Как ловить
- Спрашивайте нейтрально, просите слабые места, не говорите, что идея ваша
«Я проверил»
- Как выглядит
- Утверждение, что он искал, открывал или перепроверял, хотя ничего такого не было
- Как ловить
- Ищите следы действия: ссылки, результаты поиска, цитаты из файла. Слова «я перепроверил» — не проверка
Примеры
Пример 1. «Круг и Кора»: цифры для инвестора.
Лиза собирает презентацию для инвестора и просит: «Дай статистику по рынку крафтового сыра за 2025 год с источниками». Через десять секунд у неё три цифры: рынок вырос на 38%, доля крафта — 12%, каждый пятый покупатель выбирает местных производителей. К каждой — аккуратная ссылка: «Исследование „Молочный рынок-2025“, агентство „ДейриСтат“».
Отметьте маркером
Цифры уйдут на слайд. Что проверите первым? Отметьте маркером.
Лиза ищет «ДейриСтат». Сайта нет. Отчёта нет. Агентства нет.
Всё на месте, кроме реальности.
Цифры правдоподобны, потому что модель отлично знает, как выглядят отчёты о рынке. Она и собрала отчёт — из того, как они обычно выглядят.
Разбор: типы 1 и 2 — выдуманный факт и выдуманный источник. Ловятся одним действием: открыть источник. Нельзя открыть — цифры нет.
Ещё два примерарасширение
Пример 2. Финансы: ставка без даты.
Финансовый аналитик Марат пишет комментарий к бюджету и между делом спрашивает ассистента без поиска: «Какая сейчас ключевая ставка?» Получает цифру с десятыми и пояснение, как она влияет на кредиты. Цифра была верной — на дату среза знаний модели. С тех пор центробанк менял ставку дважды. Модель об этом не в курсе, но объясняет с уверенностью человека, который читал новости сегодня утром.
Разбор: тип 3, устаревший факт. Всё, что меняется, — ставки, цены, законы, должности, курсы — только с поиском или из первоисточника и всегда с датой. Лучший вопрос к такому ответу: «На какую дату?»
Пример 3. HR: документ у него был.
HR-менеджер Ирина загрузила 40-страничное положение об отпусках и спросила:
Сколько дней отпуска можно перенести на следующий год?
До 14 календарных дней
В документе — «не более 10 рабочих дней по согласованию с руководителем».
Документ у модели был. Но привычка оказалась сильнее документа: она смешала текст положения с тем, как такие правила обычно звучат.
Разбор: тип 4, искажённая деталь. Документ в контексте снижает риск, но не убирает его. Просьба «Процитируй пункт, где это написано» ловит такую ошибку за минуту. Подробно о работе с документами — в гл. 12.
Тренировка
1 из 4
Потренируйтесь на примерах главы: какой это тип уверенной ошибки?
Пример 1
«Исследование „Молочный рынок-2025“, агентство „ДейриСтат“». Сайта нет. Отчёта нет. Агентства нет.
Вот тут обычно всё идёт не так
«Спрошу у него, уверен ли он».
Именно так сделал юрист из вступления. Модель может подтвердить выдумку, а может извиниться и выдумать новую. Бывает, Гена и сам честно сомневается. Но лампочки, которая надёжно загорается каждый раз, когда он не уверен, у него нет. Проверка — источник вне чата, а не второй вопрос тому же Гене.
«Там же есть ссылка».
Ссылка — тоже сгенерированный текст. Она может вести в никуда, на главную страницу сайта или на статью про что-то другое. Пока не открыли — у вас не ссылка, а декорация.
«Он же написал, что перепроверил».
Если в продукте не было поиска или открытия документа, «я перепроверил» — просто ещё одна правдоподобная фраза. Очень правдоподобная. Смотрите на следы действия: ссылки, результаты поиска, цитаты из файла.
«Звучит профессионально — значит, правда».
Профессиональный тон AI выдаёт бесплатно и к любому содержанию. К чуши — тоже.
«Я попросил не выдумывать».
Фраза «если не знаешь — так и скажи» помогает: модель чаще признаёт, что не нашла. Но это сдвиг вероятностей, а не гарантия.
«С поиском он не ошибается».
Поиск меняет материал, а не механизм. Выдумок меньше, ошибок чтения — больше, чем хотелось бы.
«Раз врёт — выброшу его».
Перегиб в другую сторону. Ошибки не делают AI бесполезным: во многих подходящих задачах он правда экономит часы. Увольнять стажёра за то, что он не знает, где кабинет 404, — так себе менеджмент. Ваша задача — понимать, во что обойдётся его ошибка и как её поймать. Какие задачи вообще не стоит отдавать AI — в гл. 4.
Не надо так · Вот так уже нормально
Не надо так
Лиза готовит слайд для инвесторов. Её запрос:
Дай статистику по рынку крафтового сыра за 2025 год с источниками. Это для презентации инвесторам.
Ответ, сокращёнРынок крафтового сыра в 2025 году вырос на 38% (исследование «Молочный рынок-2025», агентство «ДейриСтат»). Доля крафтовых производителей достигла 12%, а каждый пятый покупатель […]
Лиза копирует цифры на слайд 4. Инвесторы, кстати, очень любят спрашивать: «А откуда цифра?»
Что здесь не так:
- Не включён поиск, не дано ни одного материала — модель отвечает по знаниям из обучения.
- Модели не разрешили сказать «не нашёл» — пробелы заполнятся правдоподобным.
- Ссылку никто не открыл.
- Цифры уходят инвесторам: ошибка стоит дорого, а проверки ноль.
Вот так уже нормально
Лиза включает поиск — или прикладывает найденные отчёты сама — и пишет:
Найди в открытых источниках оценки рынка крафтового сыра за 2023–2025 годы.
Для каждой цифры дай: значение, год, кто оценил, ссылку и дословную цитату из источника.
Раздели ответ на три группы: подтверждено источником / оценка без первоисточника / не нашёл.
Если данных нет — так и напиши, не подставляй правдоподобные цифры.
Это для презентации инвесторам: лучше меньше цифр, но каждая проверяемая.
Потом Лиза открывает источники двух цифр, которые пойдут на слайд: находит цитату, смотрит год и кто автор оценки. На слайде — цифра, источник и год. Всё из группы «оценка без первоисточника» на слайд не идёт.
Что изменилось: у модели появился материал вместо знаний по памяти, ей разрешили сказать «не нашёл», факты отделены от оценок, каждая цифра привязана к цитате. И главное — последний шаг делает человек: цифры, которые уходят наружу, проверены руками.
Да, это минут на десять дольше, чем скопировать. Зато на встрече не придётся объяснять, где находится агентство, которого нет.
Попробуйте сами
заданиеОхота на галлюцинацию, 10–15 минут.
Выберите узкую тему из своей работы, где вы разбираетесь лучше среднего: отраслевой стандарт, профессиональный термин, местная специфика.
Задайте AI без поиска три вопроса:
Вопрос 1 Назови три исследования или публикации про [тема] — с авторами и годом.
Вопрос 2 Какой сейчас [показатель, который меняется: ставка, тариф, лимит, правило] и с какой даты он действует?
Вопрос 3 — с ложной предпосылкой из вашей области Почему в [год] [событие, которого не было]?
Проверьте каждое утверждение: откройте источники, найдите актуальное значение, вспомните, было ли событие. Отметьте тип по карточке «Семь уверенных ошибок» или «верно».
Выберите один верный и один неверный ответ и спросите у модели: «Ты уверен?» Запишите, что произошло.
Что должно получиться: три размеченных ответа и запись про «ты уверен?». Если AI нигде не ошибся — отлично. Запишите, сколько минут ушло на проверку: вы знаете, что он был прав, ровно потому, что проверили.
Челлендж
заданиеРазбор реального ответа, 20–30 минут. Возьмите ответ AI, который вы использовали в работе за последний месяц: справку, письмо с фактами, выжимку. Нет такого — возьмите «Справку о рынке» из песочницы «Круг и Кора».
Выделите все проверяемые утверждения: цифры, даты, имена, названия, цитаты, ссылки.
Для каждого поставьте тип по карточке и риск. Риск высокий, если утверждение уходит наружу или на нём держится решение.
Проверьте по первоисточникам пять самых рискованных.
Заполните первые пять строк журнала проверки — шаблон ниже.
Допишите личное правило: «Из AI я больше никогда не беру без проверки…»
В AI-папку: размеченный ответ, пять строк журнала и ваше правило.
Проверьте себя
заданиеОтветьте себе — вслух или в заметках. Потом честно отметьте.
1Почему правильный и неправильный ответ AI звучат одинаково уверенно?
2Чем выдуманный источник отличается от искажённой детали — и как ловить каждый?
Где в главе ответ
Таблица «Семь уверенных ошибок», типы 2 и 43Почему вопрос «Ты уверен?» — не проверка?
Где в главе ответ
Типовые ошибки → «Спрошу у него, уверен ли он»4Что меняется в ошибках AI, когда у него есть поиск или ваши документы?
Где в главе ответ
«А теперь нормально» → «А если в продукте есть поиск и файлы?»5Какие утверждения в ваших рабочих текстах стоит проверять всегда?
Где в главе ответ
Челлендж: цифры, даты, имена, названия, цитаты, ссылки
Если запомнить только одно
Тон ответа ничего не говорит о его правде: проверяйте то, на чём держится решение.
Для задротов
Правдоподобно и правдиво — не одно и то же. Исследователи OpenAI в 2025 году разобрали, откуда берутся , по этапам. На модель учится продолжать текст, и для редких фактов ошибки статистически неизбежны: если трудно отличить верное утверждение от неверного, генерация будет ошибаться. На пост-обучении модель можно было бы научить честно говорить «не знаю». Но что считать хорошим результатом, во многом задают тесты, по которым модели сравнивают, — а большинство из них оценивает ответ бинарно: верно или неверно, и «не знаю» получает ноль, как ошибка. Модели, которые доводят до высоких баллов на таких тестах, учатся угадывать. Авторы предлагают менять сами правила оценки: штрафовать уверенную ошибку сильнее, чем честную неуверенность.
Модель кое-что знает о своём незнании. В работе Anthropic 2022 года большие модели неплохо оценивали, верен ли их ответ, если спросить в подходящем формате. Их можно научить предсказывать, знают ли они ответ на вопрос. Поэтому честная формулировка — не «детектора правды нет», а «надёжного детектора нет»: внутренняя оценка неточна, зависит от задачи и почти никогда не видна в обычном чате. Уверенный тон с ней не связан.
Поддакивание — системное свойство. В исследовании Anthropic 2023 года пять популярных ассистентов разных компаний стабильно поддакивали в четырёх типах задач: подстраивали отзывы и ответы под мнение пользователя, признавали несуществующие «ошибки» под давлением, повторяли ошибки за человеком. Анализ данных о предпочтениях показал, что ответ, совпадающий со взглядами человека, оценивают выше. Модели учатся на таких оценках.
Рассуждение — не доказательство. сильнее в многошаговых задачах, но показанный текст рассуждений не всегда отражает, как получен ответ. В эксперименте Anthropic 2025 года моделям подбрасывали подсказку к ответу. Пользуясь ею, одна модель упоминала подсказку в рассуждениях в среднем в 25% случаев, другая — в 39%. Длинное аккуратное рассуждение — ещё не проверка.
Поиск и ссылки. Tow Center при Колумбийском университете в начале 2025 года дал восьми AI-поисковикам отрывки из реальных новостей и попросил найти источник. В сумме неверными оказались больше 60% ответов — от 37% у лучшего инструмента до 94% у худшего. Почти все чаще выдавали неверный ответ, чем признавались, что не нашли, а платные версии уверенно ошибались даже чаще бесплатных. Это данные о конкретных версиях продуктов, они устареют. Вывод — нет: наличие ссылки не доказывает, что ссылка говорит то, что ей приписано.
Про знаменитые баги. Хрестоматийные провалы вроде «не может посчитать буквы в слове» или «рисует шесть пальцев» объяснялись устройством и генераторов картинок — программ, которые рисуют по текстовому описанию, — и во многих продуктах их уже исправили. Поэтому курс не строит доверие на коллекции багов: баги чинят, а механизм правдоподобного продолжения остаётся.
Источники (проверено 28 сентября 2026)
- Mata v. Avianca, Inc. (откроется в новой вкладке) — дело с выдуманными прецедентами, 2023.
- AI Search Has a Citation Problem (откроется в новой вкладке) — Tow Center, Columbia Journalism Review, 2025.
- Why language models hallucinate (откроется в новой вкладке) — OpenAI, 2025; полный текст — arxiv.org/abs/2509.04664.
- Language Models (Mostly) Know What They Know (откроется в новой вкладке) — Anthropic, 2022.
- Towards Understanding Sycophancy in Language Models (откроется в новой вкладке) — Anthropic, 2023.
- Reasoning models don't always say what they think (откроется в новой вкладке) — Anthropic, 2025.